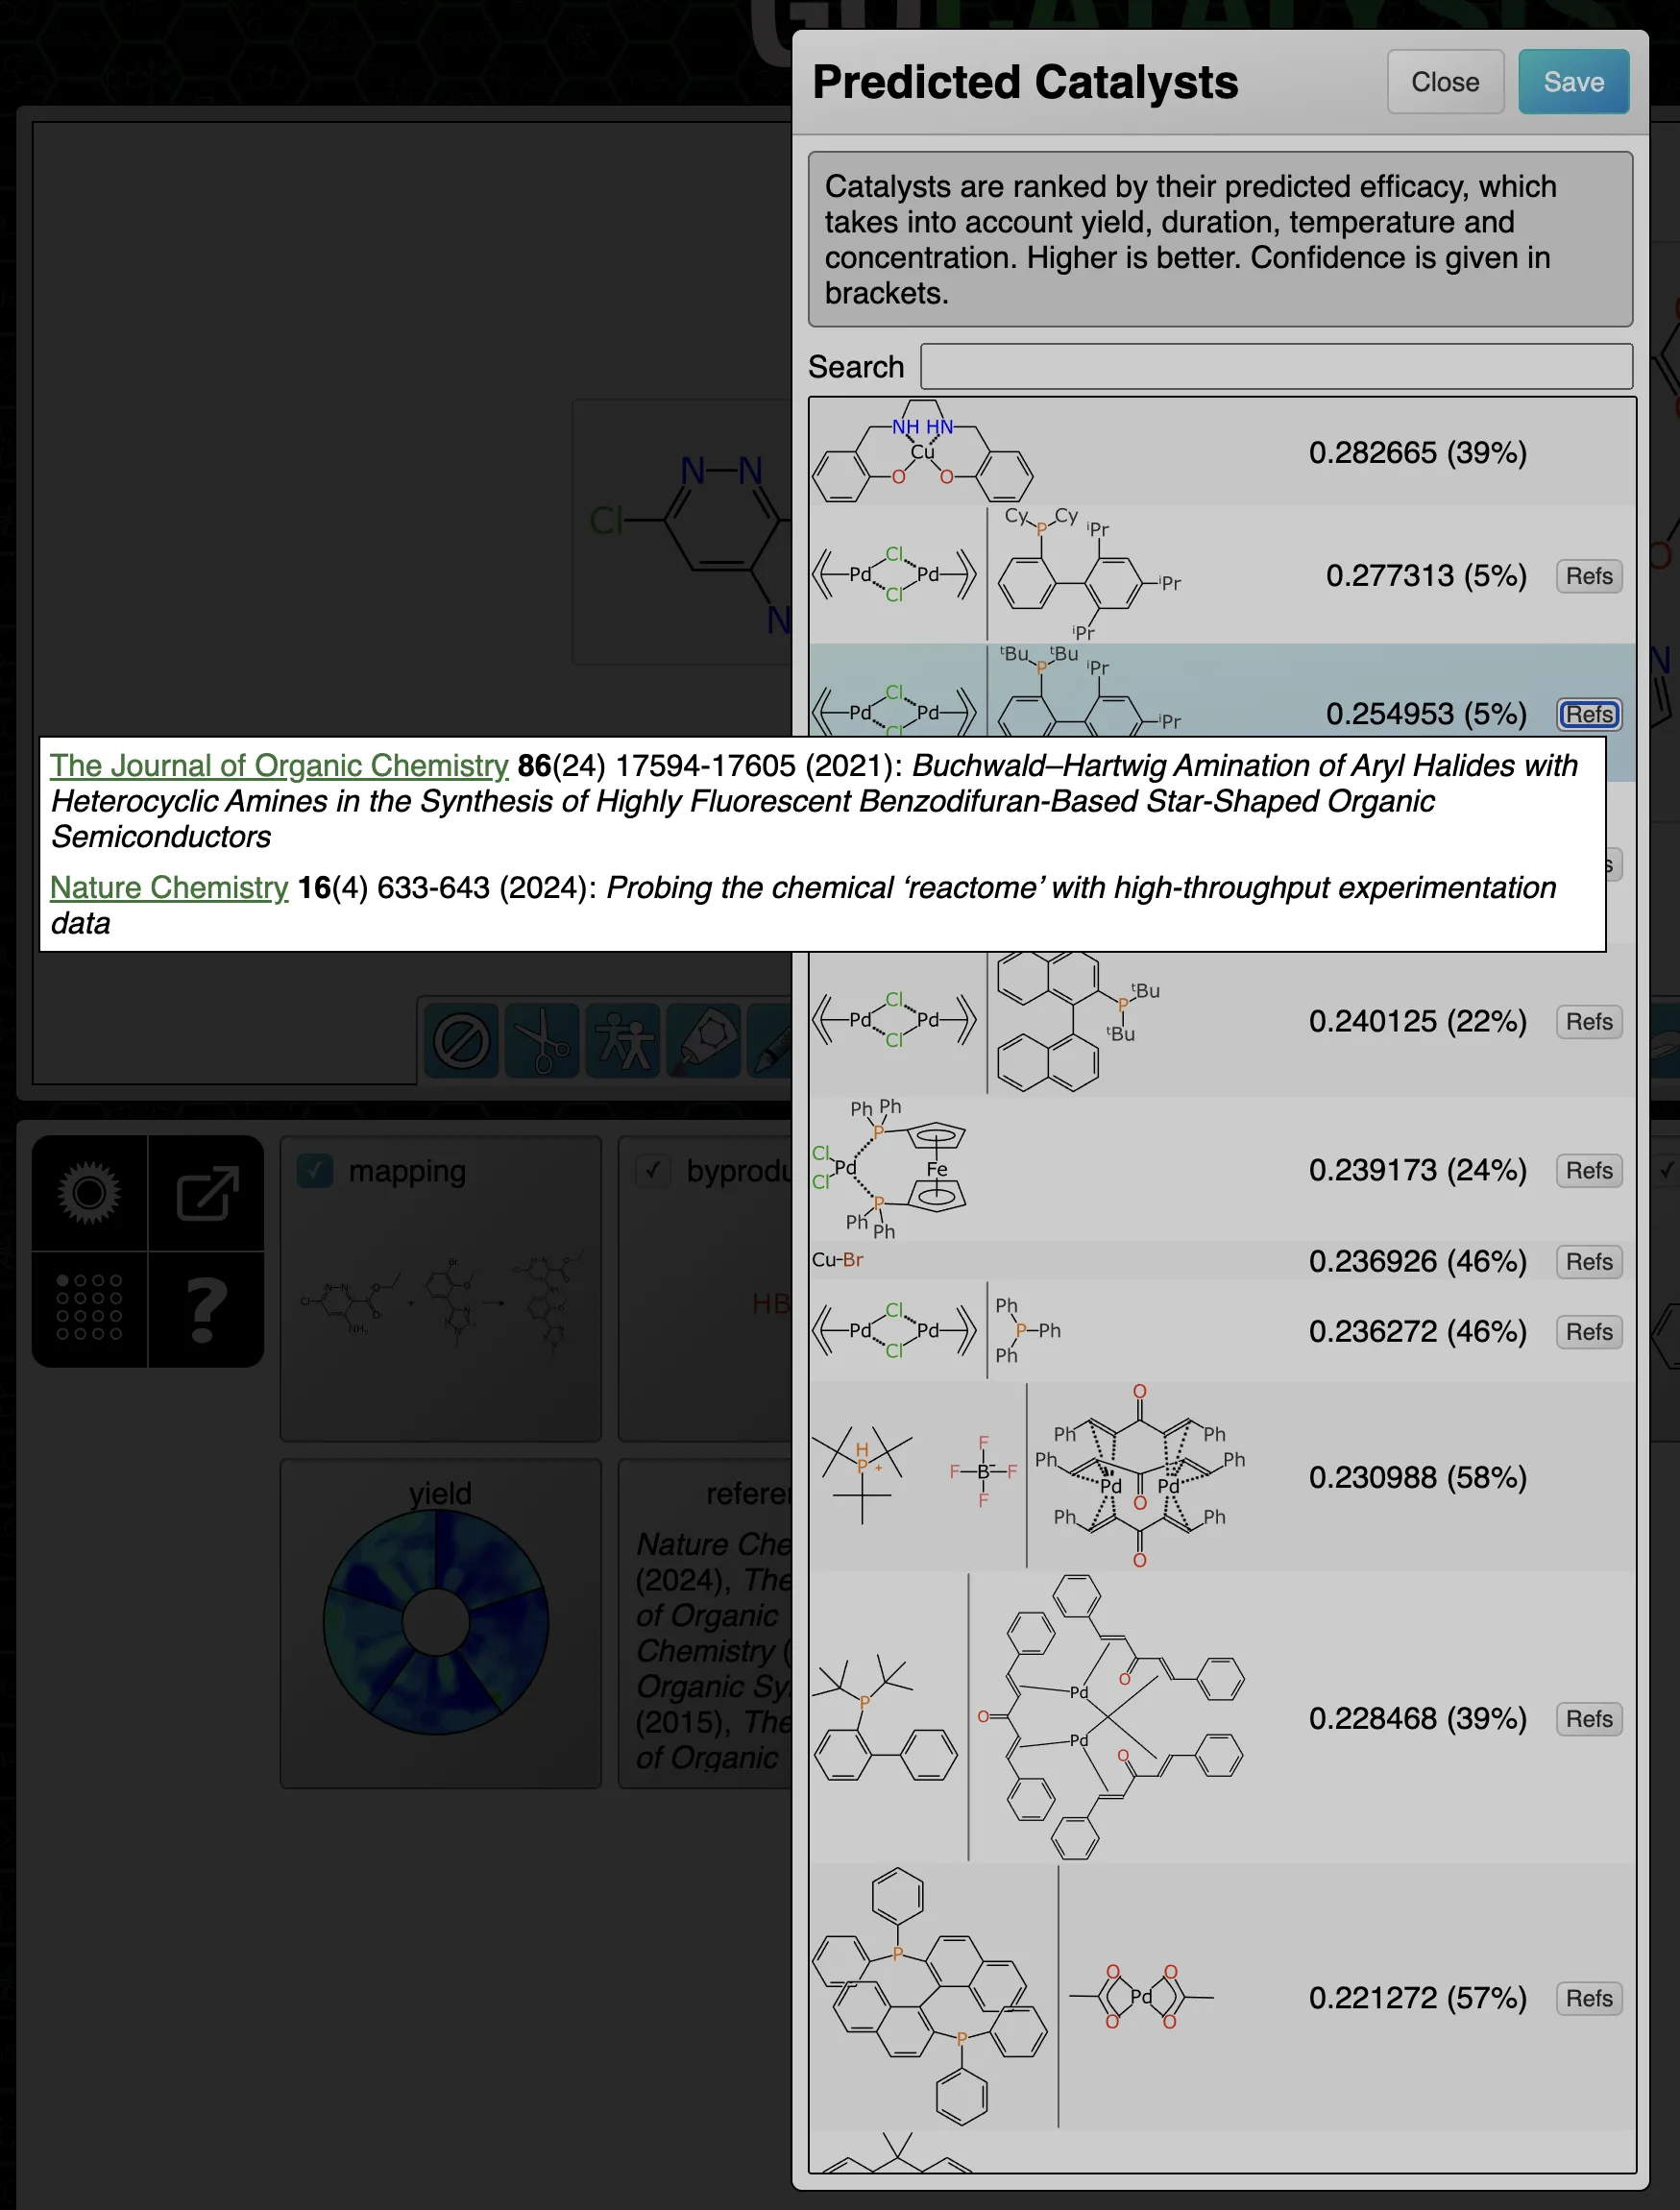
گاهی اوقات بهترین راه برای اعتبار بخشیدن به یک پیش بینی این است که ادبیات را بررسی کنید و به دنبال مشابه ترین نمونه ها بگردید تا ببینید آیا به نظر منطقی می رسد یا خیر. خوشبختانه، دادههایی که این ابزارهای پیشبینی واکنش بر اساس آنها هستند، معمولاً با یک DOI متصل هستند، بنابراین این ویژگی میتواند به طور خودکار به صورت جادویی اضافه شود.
این مجموعه ای از مقالات در مورد پیش بینی واکنش است. خلاصه و فهرست مطالب را می توانید در اینجا بیابید. وب سایتی که این قابلیت را ارائه می دهد در حال حاضر در نسخه آزمایشی بسته است، اما اگر علاقه مند به امتحان آن هستید، کافی است به alex.clark@hey.com ایمیل بزنید و خود را معرفی کنید.
توضیح اینکه چرا یک مدل شبکه عصبی پیش بینی خاصی انجام می دهد معمولاً تا حدودی چالش برانگیز است. پاسخ تحت اللفظی به این دلیل است که وقتی این ماتریس ها را با هم به این ترتیب ضرب می کنیم، بهترین تناسب کلی بین پیش بینی شده و مشاهده شده را فراهم می کند. دلیل اینکه چرا یک پیشبینی امتیاز بالا یا پایین دریافت میکند آنقدر مبهم است که باید به عنوان یک جعبه سیاه در نظر گرفته شود. یکی از راههای کمک در این شرایط، ایجاد یک معیار اعتماد است، اما این نیاز به یک جهش ایمان دوم دارد.
در این مجموعه تاکنون چندین مورد به داده های آموزشی اشاره شده است و این که از واکنش هایی با دقت انتخاب شده تشکیل شده است که در طرح کامل در نظر گرفته می شوند. همه ساختارها حضور دارند و با نقشها برچسبگذاری میشوند و اجزای استوکیومتری نقشهبرداری و متعادل میشوند. این و چندین معیار دیگر به عنوان یک الزام سخت برای پذیرش در خط لوله ساختمان مدل استفاده می شود.
از آنجایی که بیشتر دادههای ورودی از مقالات ادبیات انتخاب میشوند، اسناد نظارتی با یک DOI (شناسه شی دیجیتال) علامتگذاری میشوند، که راه دیگری برای گفتن اینکه پیوندی به مقاله منتشر شده داریم. بنابراین اگر بتوانیم نمونههایی از دادههای آموزشی را پیدا کنیم که برای یک پیشبینی مناسبتر هستند، پس نمایش آنها بهعنوان روابط راهی کارآمد برای یافتن توضیحی محتمل برای اساس یک پیشبینی است. و حتی اگر خواندن مقاله شما را متقاعد کند که پیشبینی آنقدرها هم عالی نبوده است، احتمالاً مرتبط خواهد بود، بنابراین یک جایزه تسلیبخش مناسبی است.
یافتن مرجع ادبیات شامل ایجاد اثر انگشت برای نمودار مورد نظر است:
- تغییر اثر انگشت برای اجزای استوکیومتری
- اثر انگشت ساختاری برای کاتالیزورها و حلال ها
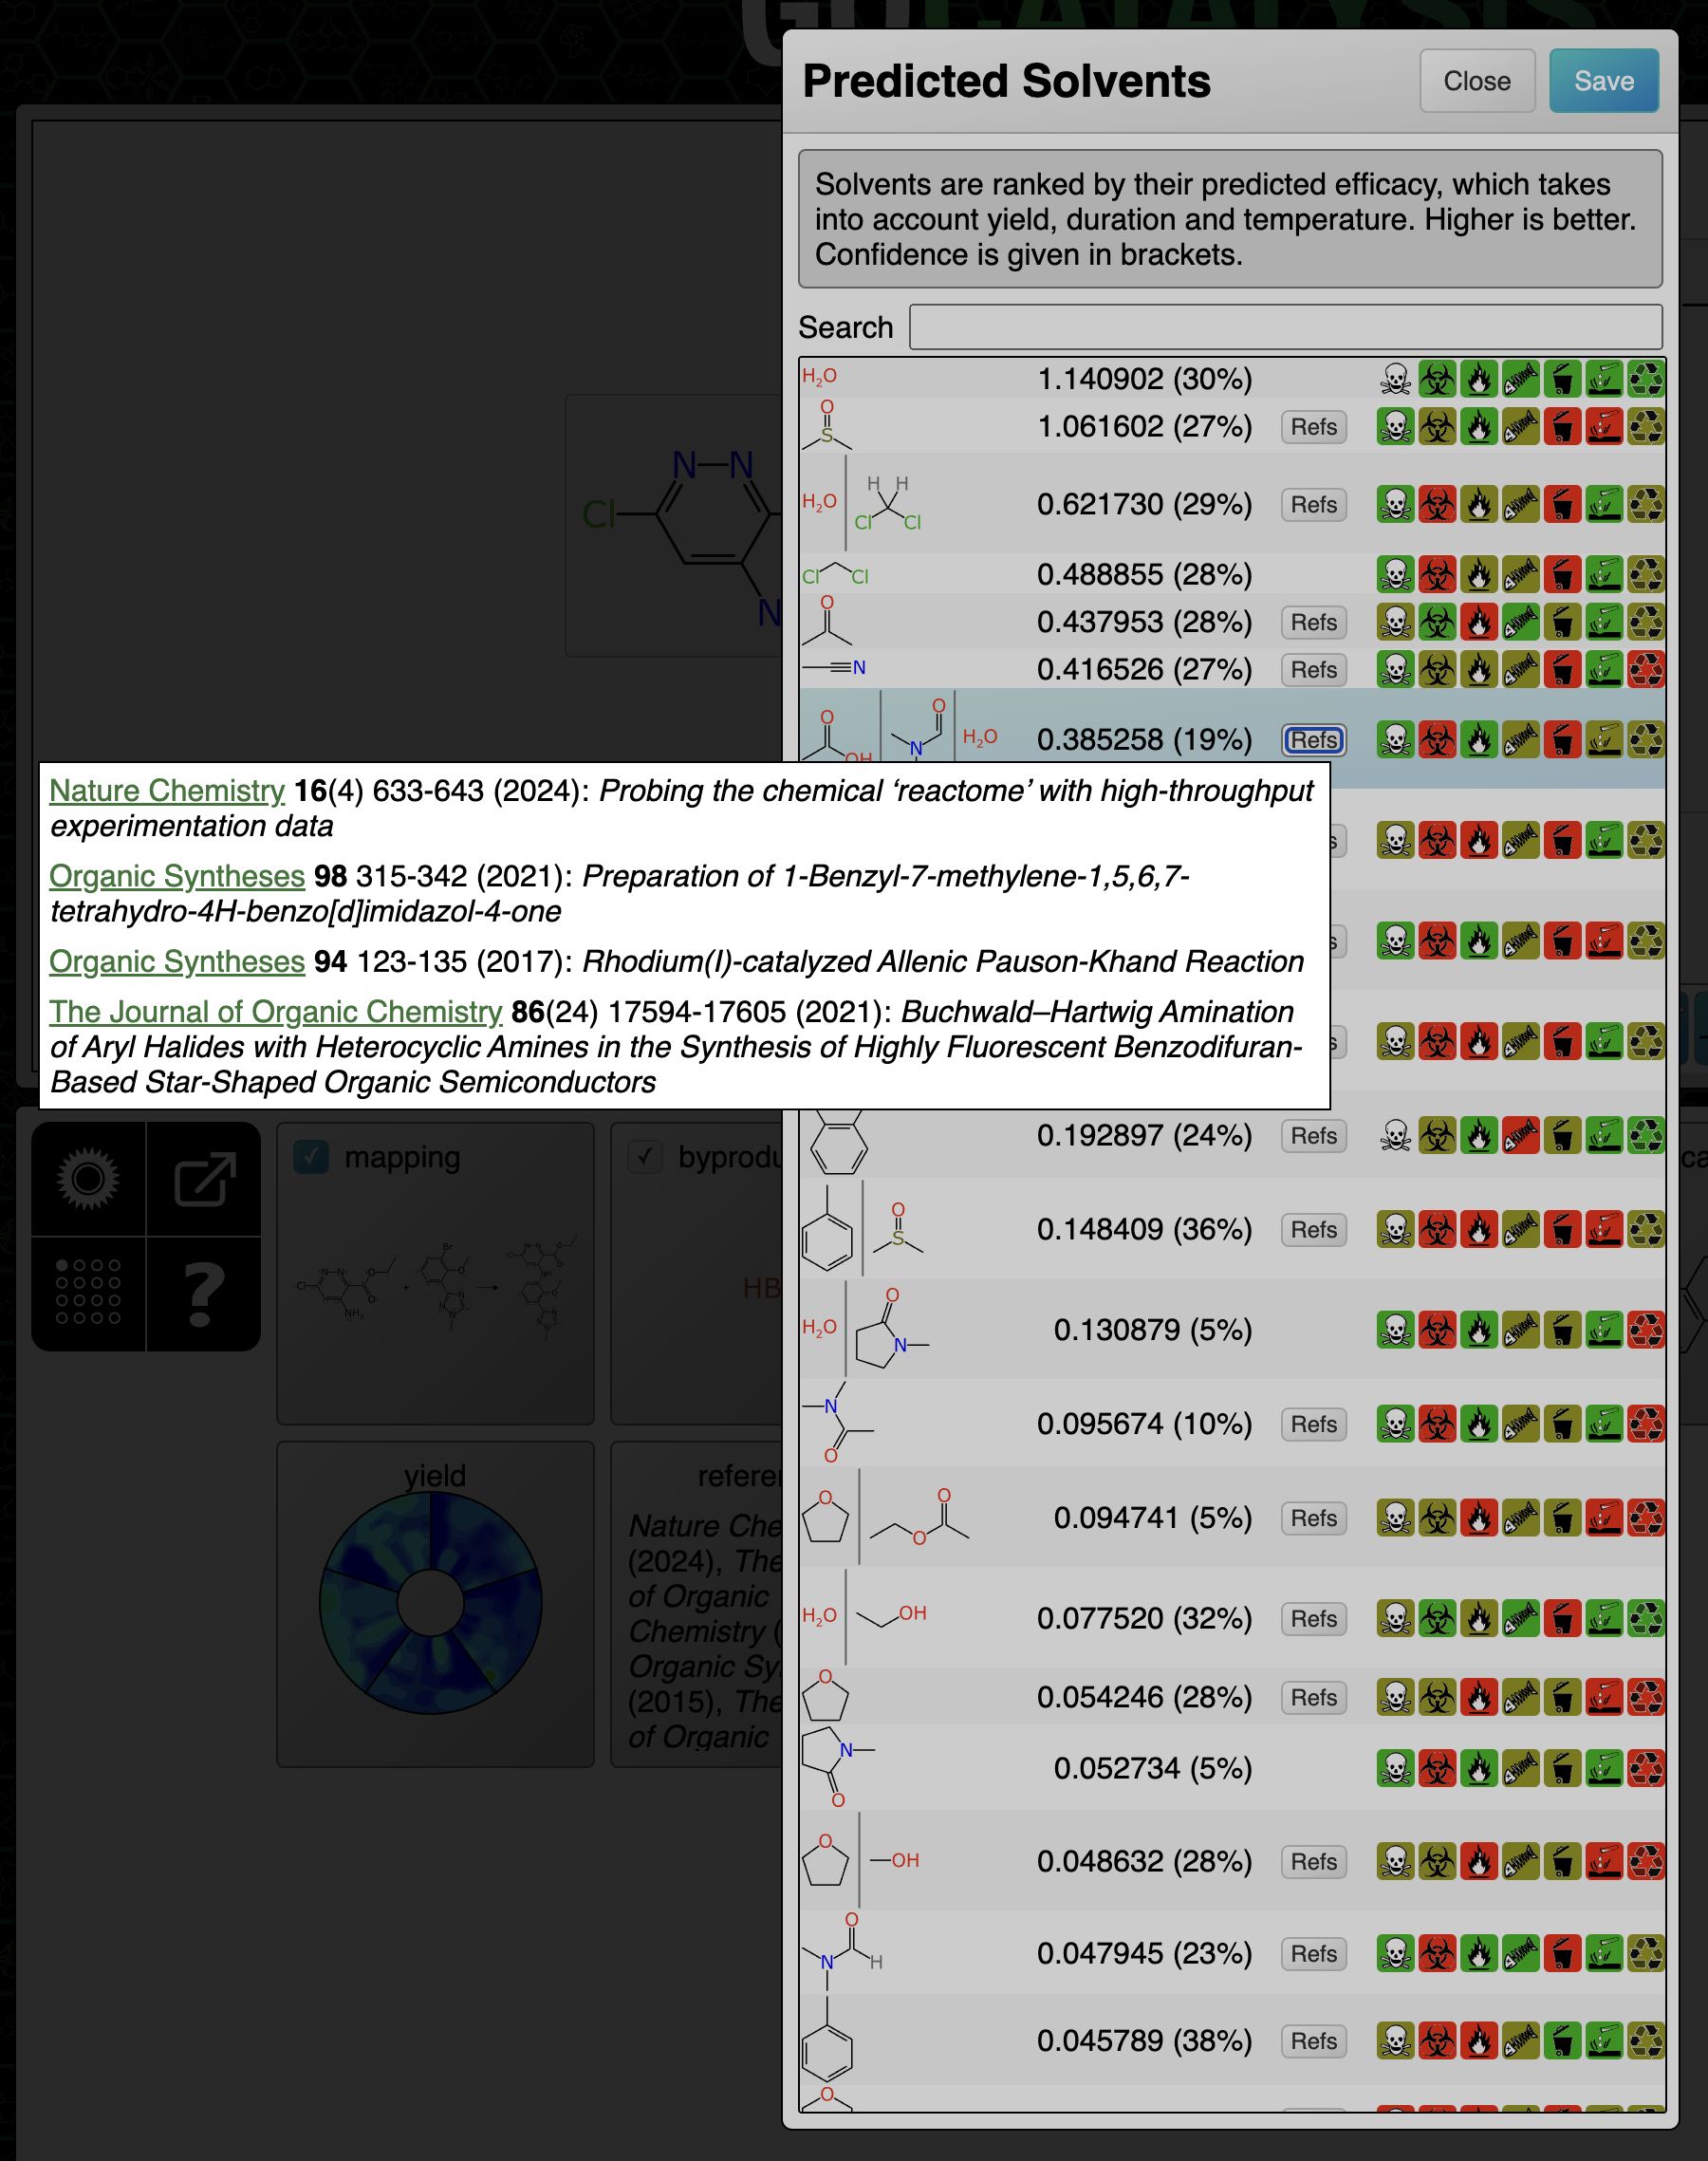
مقایسه ها را می توان به سادگی با استفاده از متریک محبوب Tanimoto و تمرکز بر دسته های مختلف در صورت لزوم انجام داد. سه مکان در رابط وجود دارد که تشبیهات ادبی ظاهر می شوند. نتایج فقط زمانی نمایش داده می شوند که رکوردی حاوی DOI با حداقل آستانه شباهت وجود داشته باشد، بنابراین گاهی اوقات چیزی برای نمایش وجود ندارد.
کاتالیزورها و حلال ها: منابع با شباهت کاتالیزور/حلال به عنوان عامل اولیه و شباهت تبدیل به عنوان عامل ثانویه گردآوری و رتبه بندی می شوند. از آنجایی که فقط واکنشهایی با تبدیل پایه یکسان در نظر گرفته میشوند، این به طور موثر شباهت جانشینها را اندازهگیری میکند.
در پایان دنباله پیشبینیها، پاسخ فرضی که در صورت اعمال همه پیشنهادات دارای رتبه برتر جمعآوری میشد، با همه دادههای آموزشی مقایسه میشود. نتایج بر اساس مشخصه ای که شبیه ترین است تقسیم می شوند، به عنوان مثال. به دلیل کاتالیزور مشابه، حلال مشابه یا تبدیل مشابه:
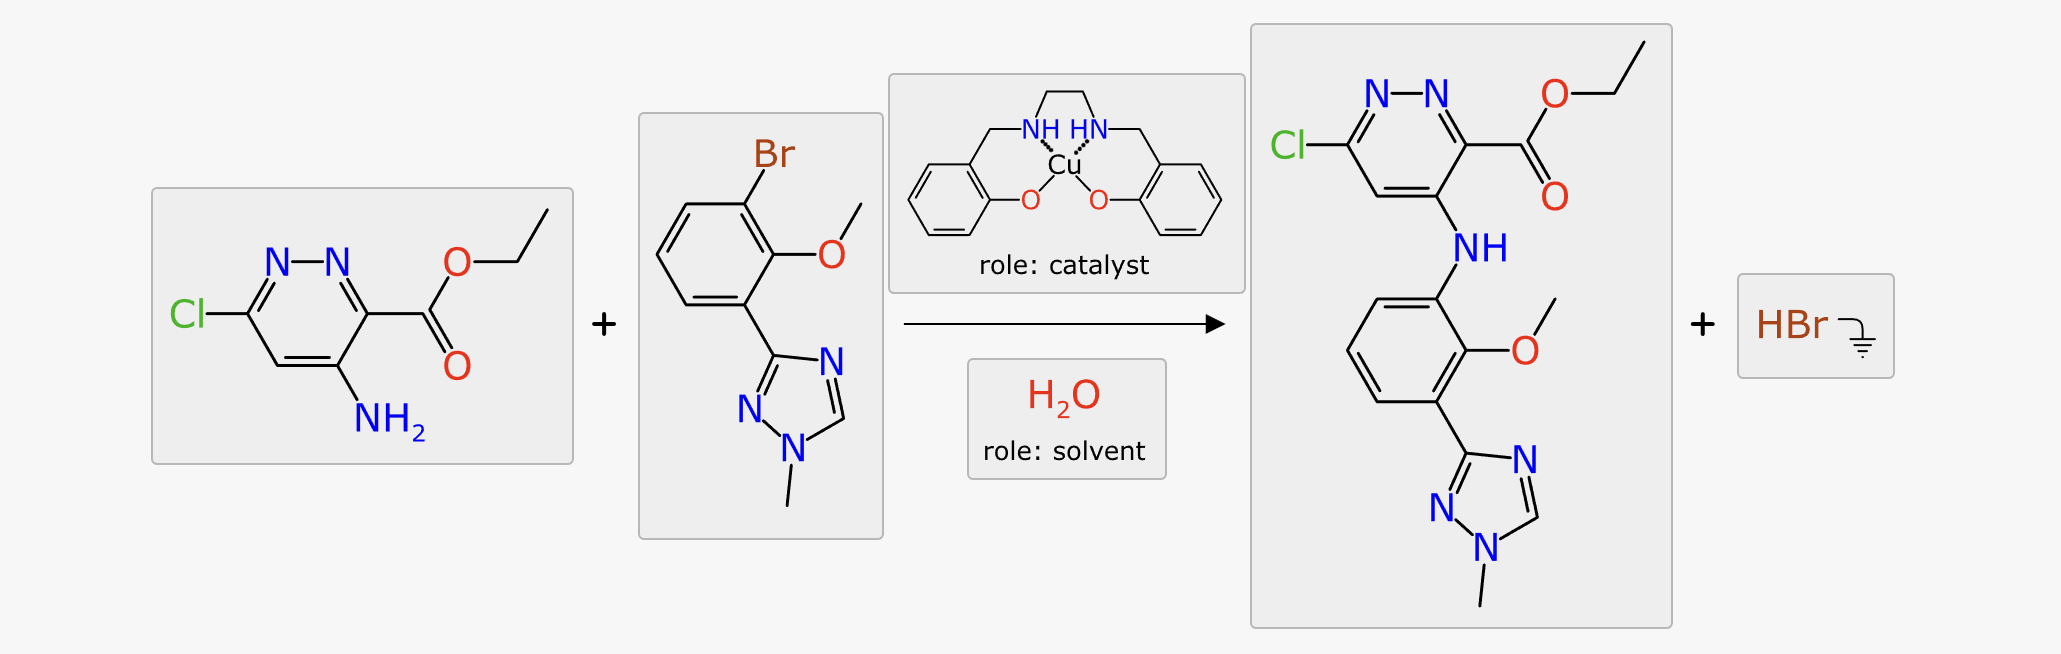
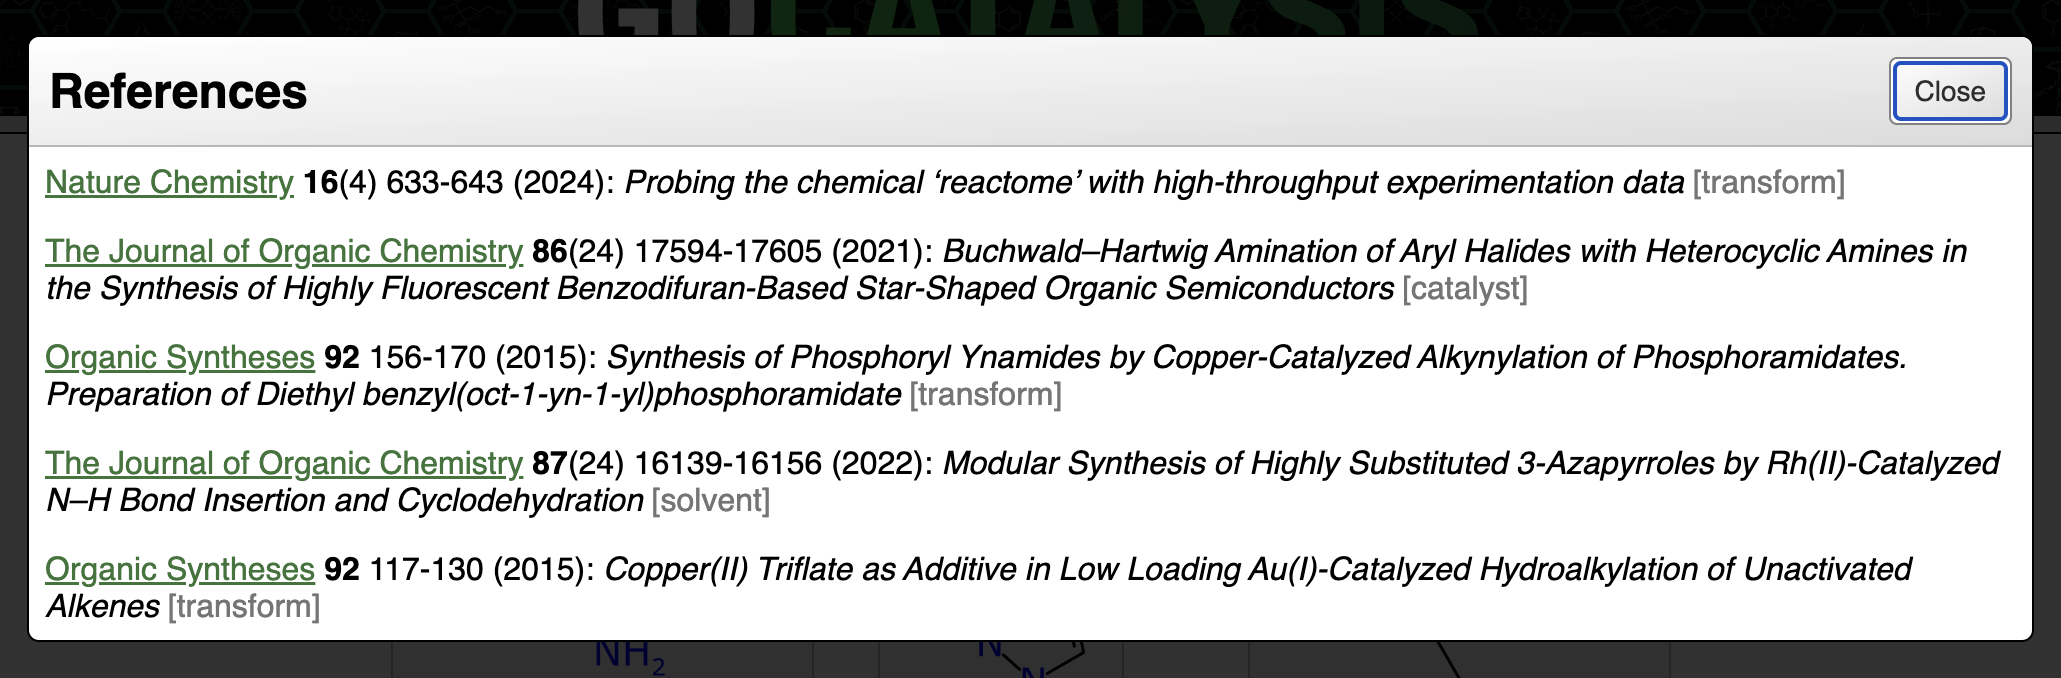
این قابلیت برای استخراج یک منطق موجه از یک پیش بینی به صورت موردی بسیار مفید است. بیشتر ارجاعات مربوط به مقالاتی است که مجموعهای از واکنشها را توصیف میکنند، اما اینها به خصوص برای مقالات روش کاتالیزوری ارتباط نزدیکی با هم دارند، بنابراین موضوع معمولاً برای کار قابل استفاده است. همچنین میتواند فقط برای انجام جستجوی واکنش مستقیم مفید باشد، اگرچه کل دادههای پشت صحنه بخش کوچکی از کل ادبیات است.
مقاله بعدی این مجموعه، خطوط استخراج را شرح می دهد.


