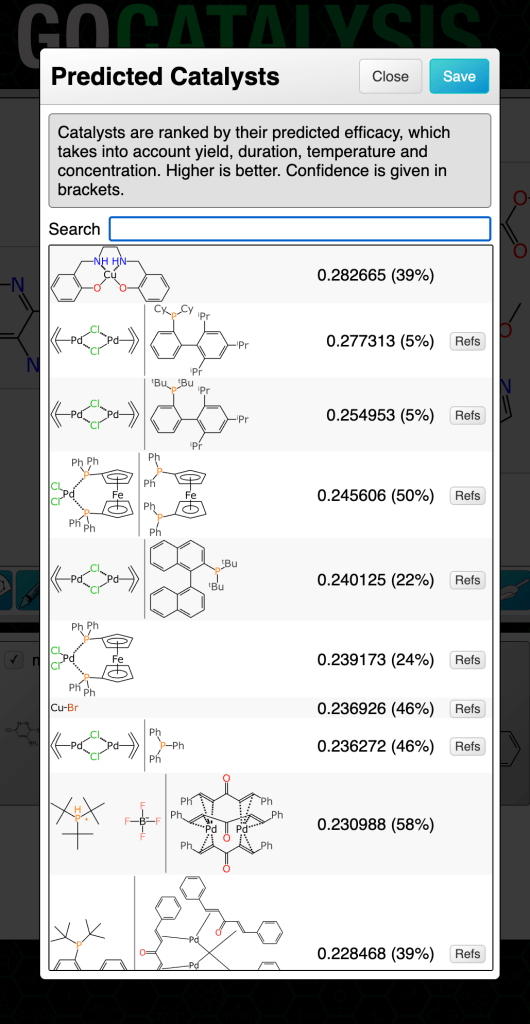
مبدل ها و حلال های کاتالیزوری بسیار خوب هستند ، اما برخی از پیش بینی ها نسبت به سایرین قابل اطمینان تر هستند. رفتن با نوعی شاخص برای ارزیابی تفاوت ، پیشرفت بسیار خوبی در سودمندی است.
این یک سری مقاله برای پیش بینی واکنش است. می توانید بررسی خلاصه و محتوای مطالب را در اینجا پیدا کنید. وب سایتی که این عملکرد را ارائه می دهد در حال حاضر در نسخه بتا بسته است ، اما اگر علاقه مند به امتحان کردن آن هستید ، فقط یک ایمیل به alex.clark@hey.com ارسال کرده و خود را معرفی کنید.
هرکسی که الگویی از انواع مختلف ایجاد کرده است با ایده داشتن یک شاخص که نشان می دهد مدل چگونه داده های آموزشی خود را تولید می کند ، و همچنین مجموعه ای از داده های آزمایش ، که از نظر اسمی مستقل است ، آشنا است. غالباً متریک مورد استفاده برای هدایت ساختمان مدل کاملاً تفسیر می شود (به عنوان مثال ، فاصله اقلیدس به مرجع واقعی یا میانگین از نزدیک در یک مربع) و بسیاری دیگر وجود دارد ، مانند R محبوب2 متریک همه این شاخص های متداول یک چیز مشترک دارند: آنها اعمال می شوند همه چیزنه به یک پیش بینی خاص.
در مورد یافتن روش هایی برای تعیین شاخص خطای نقطه داده های جداگانه ، اینترنت ساکت و غیر مشخص است. در صورت داشتن توصیف کننده ، برخی از مقالات آسان و ساده وجود دارد که اگر توصیف کننده ای داشته باشید ، این مشکل را برای شما حل می کند ، اما برای همه نوع رگرسیون چند بعدی؟ پاسخ ها وجود ندارد یا به خوبی پنهان است. و من از چند متخصص در مورد این موضوع پرسیدم که شکست خورده اند یا نمی خواستند مرا به چیزی هدایت کنند که می توان به آن دست یافت.
بعد از مدتی در نظر گرفتن مشکل ، سناریوها را کاهش دادم تا اساس یک مدل را به سه دسته از آرکیپت ها پیش بینی کنم:
- پارامترهای ورودی در منطقه ای قرار می گیرند که با داده های آموزش متراکم است و همبستگی بین پارامترها و خروجی ها قوی است
- حوزه فضای پارامتر از نزدیکی با داده های آموزش برخوردار است ، اما به دلایلی مدل در این منطقه عملکرد خوبی ندارد
- فضای پارامتر به دور از حوزه آموزش است ، که منجر به بد پیش بینی بد می شود
تولد روشهای مختلف برای ساختن یک مدل از مدل ، اما در پایان ، رویکردی که من را به اسیر من جلب کرد ، بررسی رویکرد نسبتاً کم -تکنیک بود: نتیجه گیری Bayyesov. گونه های خاص خاص تر به نام Lapcianian Bayes ساده لوح را تصحیح می کندS این یک روش خارق العاده برای گفتن است که به جای اضافه کردن نسبت های اولویت ، شما را با کمک اضافه می کنید ورود به سیستم عملکرد. این روش ، با استفاده از هزاران اولویت ، با هزینه دیستالگرایی نتیجه خروجی ، که دیگر احتمال وجود ندارد ، امکان پذیر است و به جای آن باید با استخراج پس از تنظیم تغییر یابد.
این رایحه مدل Bayesovo برای پیش بینی فعالیت تشخیص دارو بسیار مفید است ، که اغلب با ECFP جفت می شودx (همچنین به عنوان مورگان شناخته می شود) اثر انگشت. تا زمانی که بتوانید نتیجه خروجی خود را به باینری بله/خیر کاهش دهید ، سپس اولویت ها (یا اثر انگشت در این زمینه) اولویت های زیر را داشته باشید:
- اگر اثر انگشت در بخش بسیار بزرگی از موارد مثبت وجود داشته باشد ، اثر افزودنی بالایی دارد
- اگر اثر انگشت بیشتر در موارد منفی مشاهده شود ، اثر اضافه اضافه ای دارد
- اگر اثر انگشت در داده های آموزشی مشاهده نشود ، هیچ تأثیر دیگری ندارد
سه نقطه گلوله همزمان با لیست آرکیپ های فوق نبود. در حالی که اثر انگشت ترکیب ورودی ها را به روشی مشابه با مدل مناسب ضبط می کند (یعنی استفاده از اثر انگشت به دست آمده از ساختارهای شیمیایی به عنوان آنالوگ لایه های پنهان شبکه عصبی به دست آمده از گرافیک های شیمیایی) ، پس آنها قابل مقایسه هستند.
برای مدل های کاتالیزور و حلال به طور جداگانه باینری خروجی: برای هر ضبط در مجموعه آموزش ، نتیجه در نظر گرفته می شود مثبت اگر پیش بینی در 0.1 از نتیجه واقعی باشد (که به خودی خود دارای محدوده عملیاتی 5-10 است). بقیه در نظر گرفته می شوند منفیIE پیش بینی های بد توجه داشته باشید که اگر نوار را کاملاً زیاد تنظیم کنید ، این نوع مدل های Bayese خیلی خوب پیش بینی می کنند ، تا زمانی که اثر انگشت با ارزش بالا را خاموش نکنید.
برای اولویت های ورودی ، به یاد بیاورید که مدل های کاتالیزور و حلال در نمودار تحول واکنش شیمیایی و نمودار شکل گیری تمرکز مولکولی (به ترتیب کاتالیزور یا حلال) تغذیه می شوند. برای هر یک از آنها تنوع ECFPx اثر انگشت استفاده می شود. تبدیل اثر انگشت از ترکیبی استفاده می کند که مقادیر اتم اولیه را برای هر یک از اتم های معرف/محصول که سمت آنها را در نظر می گیرد و نزدیک به اتم های تغییر در واکنش می سازد ، استفاده می کند ، در حالی که اثر انگشت کاتالیزور از طبقه بندی اولیه بر اساس dotpath برای محیط های اتمی استفاده می کند ، که به آن حمله می کند تا به آنها حمله کند.
دو مدل Baysovo (برای کاتالیزورها و حلالها) با هر پیش آگهی رتبه بندی خوانده می شوند و به عنوان درصد در براکت ها نشان داده می شوند:
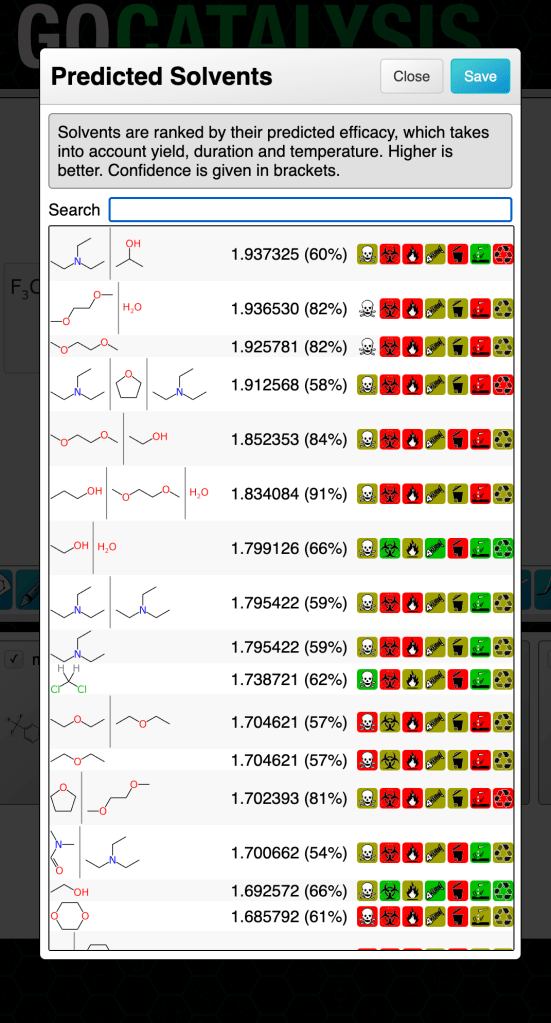
راه فکر کردن در مورد نشانگر اعتماد به نفس این است: احتمال این پیش بینی به احتمال زیاد همان چیزی است که ادعا می کند (چه زیاد ، متوسط یا پایین باشد). اگر درصد اعتماد به نفس کم باشد ، که لزوماً به معنای پیش بینی بد نیست یا مفید نیست ، به این معنی است که نتیجه را نمی توان با شواهد زیادی پشتیبانی کرد که در بخش بزرگتر از داده های یادگیری یافت می شود ، که نتایج آن به طور مداوم مطابق با حقایق تجربی است.
آیا این سختگیرترین روش برای محاسبه اعتماد به نفس است؟ احتمالاً نه – اما منطقی است ، از یک روش مستقل با حداقل استدلال دایره ای ناشی می شود و می توانم ادعا کنم که بسیار مفیدتر از یک پیش بینی و بدون صلاحیت اضافی است.


